中文 PDF → Word · 免费 · 无需注册
中文 PDF 转可编辑 Word:不再是方框和乱码
中文 PDF 出问题的方式,是英文文件不会有的:字变成空方框,变成一排问号,或者整页干脆成了 一张打不了字的图。把你的文件传上来,拿回一份中文能选中、能搜索、能重新 输入、能直接发给同事的 Word。
上传 PDF Basic 模式免费、无需账号:每天 10 页、每月 100 页;登录后每天 100 页、每月 1000 页。扫描件按页嵌入为图片,PDF 本身带有的文字仍可编辑。AI 模式把扫描件转写成真正可编辑的文字——需要登录并添加支付方式,或在下方粘贴你自己的 API key。无水印。
转换中…
默认不保留。不勾选时,你的 PDF 会按期删除;勾选后,我们仅保留它供工程师研究本次转换。随时可取消勾选。
选项 · AI / 基础 · 自带 key
高级——自带 AI 服务商
扫描件由 AI 视觉模型识别。自带你自己的服务商,即可按你选择的质量转换扫描件,费用直接付给服务商。
仅在使用你自己的 key 时生效。扫描件始终使用 AI 视觉识别。
仅用于本次转换,绝不保存、绝不记录。
最后更新:2026-09-16
为什么中文会变成方框、豆腐块和乱码
搜这个问题,搜到的往往不是产品页,而是一串论坛帖:Adobe 用户社区、Reddit 的 r/Acrobat、 chinesemac 邮件组、chinese-forums。专利译者、研究生、在整理家里旧文件的人——同一个问题被 反复问了十年。原因之一是,「乱码」这两个字被用来指三件毫不相干的事,而它们在屏幕上长得一样。
第一种:这份 PDF 里本来就没有能读出来的中文。很多中文 PDF 只嵌入了这一页 真正用到的那部分字形,有些在生成时还漏掉了把字形映射回 Unicode 的那张表。页面显示完全正常, 因为形状都在;可一旦复制出来就是一串无意义的编码,因为文字不在。这种情况下,任何依赖文本层的 转换都救不了——文本层本身就是病灶,只能把这一页当成图片重新读一遍。
第二种:转换器放弃了版面。遇到一页它搭不出来的中文——双栏的报告、带格线的 表单、一张练习卷——转换器常见的做法是把整页当图片贴进 Word,或者把文字打散进几十个互相叠着的 文本框。严格说那确实是个 .docx,但你几乎改不了一个字:一动,整页就散。
第三种:字是对的,字体没了。这一种最让人恼火,因为文件其实好好的。.docx 里存的不是字体,而是字体的名字,Word 会在打开它的那台机器上去找这个名字;找不到就替换,而中文 被替换得不好时,画出来就是那一格一格的空方框,也就是所谓「豆腐块」。你发出去的文件没坏,坏的是 显示它的那台电脑。
转之前先花三十秒判断一下:在 PDF 里选中一行中文,粘进一个纯文本编辑器。粘出来是正常的字, 说明文本层没问题,后面出的岔子要么在转换器要么在字体;什么都选不中,说明这页是扫描件; 选得中但粘出来是乱码,那就是第一种,同样得按扫描件来处理。
简体、繁体,以及两种混在一起的文件
大多数中文 OCR 工具会先让你选字形:简体一个入口,繁体另一个入口,而一份两种都有的文件该走哪边, 它没有答案。这其实是个挺奇怪的要求——很多人手上有这份 PDF,恰恰是因为他还读不全它。
这里没有这个选项。你上传 PDF,决策就结束了。文字版 PDF 的字符直接来自文件自己的文本层, 原文写的是什么就还是什么:可能是一份台湾的合同,中间引了一条大陆的标准;也可能是简繁夹杂的 学术引文。扫描页则交给 AI 视觉模型,像人一样把整页读下来,而不是套用一个你必须事先挑好的 单字形引擎。标点也是同样的道理:全角逗号、顿号、《》书名号、「」引号,出来还是它们本身, 不会被换成半角的替身。
扫描件:别的工具最容易投降的地方
扫描的中文文档是难的那一类,也正是这个转换器围绕着做的那一类。不是从 Word 干净导出的文件, 而是复印的练习卷、盖了章的通知、带格线要手填的表单、随手在桌上拍的一页。这套引擎的黄金测试 语料本身就是这些东西:中文练习卷、公文、带格线的表单。
结果这种事,看比说有用。下面这页是带四线三格的扫描中文练习卷——通常会被整页压成一张图塞进 Word 的那种页面——重建成了带真实标题、真实格线行、能直接打字的文档。
效果对比
进去是一页扫描的中文,出来是一份能改的文档。
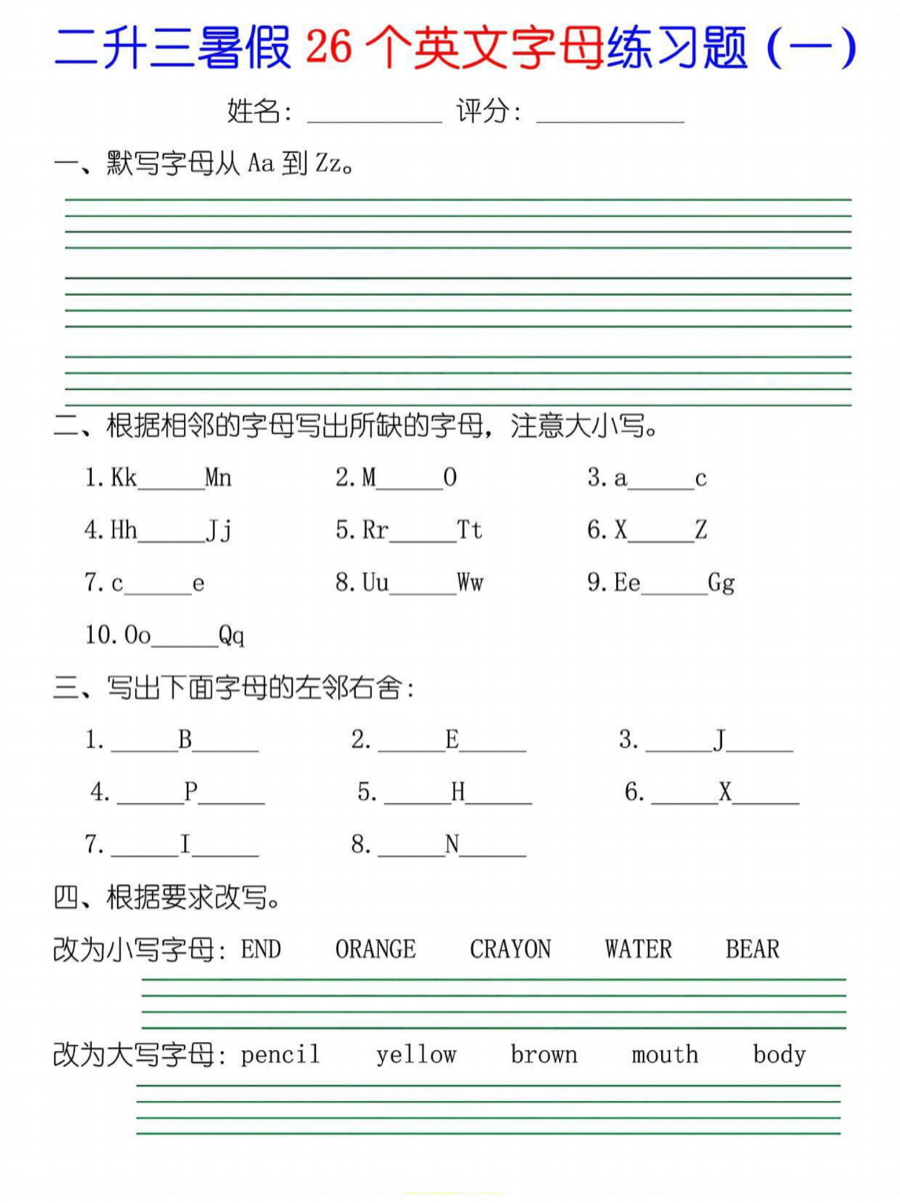
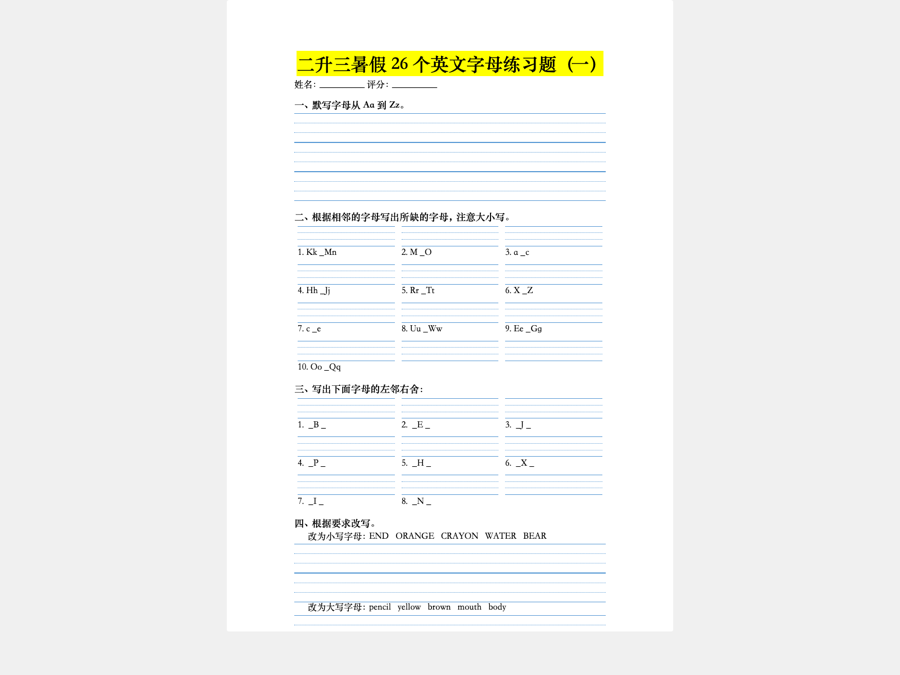
这份练习卷只是一个例子;从扫描页到可编辑文档的完整路径——OCR 单独做不到什么、「可编辑」 到底是什么意思——在扫描件 PDF 转 Word这页里讲清楚了。
你拿到的是什么
衡量一次转换好不好,不看它刚打开时像不像原件,而看你动它一下会怎样。删掉一段中文里的一句话, 段落应该自己重排;改表格里的一个数字,那一行应该稳住;插进一行,后面的内容应该往下推,而不是 整页错位。要做到这些,文档必须由真正的 Word 对象构成,而不是「一张长得像 Word 的图」:
- 标题和正文是真正的 Word 样式,可以一次性给全文换版式。
- 表格带真正的行和列,可以重新输入、调整、增删和重排——中文商务文件里大半是这种带框线的表。
- 填写线、格线和四线三格是被重建成结构的,不是画成一张图片。
- 分栏、页边距和行距在编辑时依然撑得住,公文和论文的样子不会因为你改了一行就垮掉。
- 中文可以选中、可以全文搜索——翻译记忆库和 CAT 工具要开始工作,前提就是这一条。我们不替你翻译,只是把中文原文交到你用来翻译的那个工具手里。
这和首页那套PDF 转可编辑 Word 用的是同一个引擎;单独做这一页,是因为中文 文档把所有难点凑在了一起:简繁混排、密集格线、扫描件,还有谁都不一定装了的字体。默认输出是 Word,同一次上传也可以换成 Excel 表格或 Markdown。
关于 Word 里的中文字体
这件事值得弄明白一次,因为「我这儿好好的,他那儿全是方框」基本都由它引起。Word 文件里记的是 字体的名字,不是字体本身;在找不到这个名字的机器上打开,Word 就会挑一个替代品, 而中文被替换时,轻则正文从宋体变成黑体、从衬线变成非衬线,重则整片变成方框。
名字的讲究比看上去多。仿宋、楷体随 Windows 和 Mac 版 Office 一起提供;而它们的旧注册名 仿宋_GB2312、楷体_GB2312 两边都不带,文档里写这个旧名,在 Mac 上就可能被整片换成另一种字体。 所以只要这份 PDF 里那套字体量得出来,我们写进 .docx 的就是它的现行规范名——宋体、黑体、仿宋、 楷体、微软雅黑——而不是 PDF 生成方内部用的那个拼法;我们也不会把字体文件嵌进 .docx 里。 这不是一句「所有文件都不会再出方框」的保证,只是把方框的一个可避免的成因去掉。
你这边可以做两件事。文件要发给你管不到的机器时,把中文正文设成对方一定装了的字体最稳妥; 因为正文是真正的 Word 样式,这是改一次样式的事,不是逐段刷一遍。反过来,如果是你自己看到 一片方框,先别当文件坏了:选中那段文字,看一眼字体框——如果 Word 显示的是一个你没装的字体, 下面的字其实是完好的。
三步转换
- 上传中文 PDF——简体、繁体或两者混排,文字版或扫描件都行,最多 2000 页。
- 系统逐页判断是文字还是扫描,扫描页交给 AI 视觉模型识别并重建版面。
- 下载 .docx,直接在 Word 里改中文。
没有跳转、没有弹窗、不用装软件,也不会往你邮箱里发东西。形状像幻灯片的 PDF 会自动改走 PowerPoint。转换产物大约六小时后自动删除——转合同或专利的时候,这一点值得知道。
完整的分步教程——含 Word、Google 文档各自的自带做法对比——看 PDF 怎么转成可编辑的 Word 文档这一页。
免费到什么程度,页数多了怎么办
没有水印,文字版(原生)中文 PDF 走的就是这一条。Basic 模式免费、无需账号:每天 10 页、每月 100 页;登录后每天 100 页、每月 1000 页。 大家日常粘进来的多半就是这一类——Word 或 WPS 导出的文件、论文、公告、合同。
扫描页是另一回事,因为读它每页都有真实成本。AI 模式把扫描件转写成真正可编辑的文字,需要登录并绑定付款方式,与 Basic 共用同一份账号额度;超出后按已购页数计费。 另有两条都不用你掏钱的路:一是粘贴你自己的 API key(Anthropic、OpenAI、Gemini,或任意 OpenAI 兼容 端点),按你自己的成本把扫描页转个够——自带 API key 的转换完全不计入额度。二是让这次转换退回到免费的 Basic 模式,文字页照样可编辑, 扫描页整页作为图片嵌入。按页购买的套餐列在价格页上,目前还没开放; 现在真正在跑的是免费的 Basic 模式、需要登录并绑定付款方式的 AI 模式和你自己的 key。
给繁体中文读者: PDF 轉 Word(繁體)这一页是专门为台湾读者写的。
资料来源
上文引用的各家做法均出自其官方文档,每个页面均于 2026-09-16 核对。每一家只被引用来说明其自家软件。
常见问题
中文 PDF 转 Word 常见问题
中文 PDF 转成 Word 后变成方框或问号,是怎么回事?
看起来一样,其实是三件不同的事。一是这份 PDF 里本来就没有可提取的中文——页面画得出字形,却没有把字形映射回文字的那张表,复制出来自然是乱码。二是转换器放弃了版面,把整页当图片贴进去,或者把文字打散进几十个文本框,于是什么都选不中。三是文字其实完全正确,只是文件里写的那个字体,在打开它的那台电脑上没有装,Word 只好替换,中文就被画成了空方框。三种情况的处理方式完全不同,所以先分清楚最省时间。
扫描件(图片版)的中文 PDF 能转吗?
能,这正是本工具主要针对的场景。扫描页会交给 AI 视觉模型去读,把中文内容和它周围的结构一起还原出来,再重新搭成一份 Word:真正的标题、真正的段落、真正的表格行,而不是把整页塞进一个图片框。出来的中文可以选中、可以搜索、可以直接改。Basic 模式免费,扫描页按页嵌入为图片。AI 模式把扫描件转写成真正可编辑的文字,需要登录并绑定付款方式,与 Basic 共用同一份账号额度;超出后按已购页数计费。自带 API key 的转换完全不计入额度。
简体和繁体都支持吗?混在一起的文件呢?
没有「选简体还是选繁体」这一步——你上传 PDF,决策就到此为止。文字版 PDF 的字符直接来自文件本身,原来写的是什么就还是什么;扫描页则是让模型把整页当一页来读。所以你不需要事先判断手上这份是简体还是繁体,也不需要为了一份两种字形混在一起的文件先把它拆开。
免费吗?有没有页数限制?
不用注册、没有水印。Basic 模式免费、无需账号:每天 10 页、每月 100 页;登录后每天 100 页、每月 1000 页。从 Word 或 WPS 导出的文件、论文、公告、合同,基本都属于这一类。扫描页要用 AI 视觉模型来读,每页都有真实成本:AI 模式把扫描件转写成真正可编辑的文字,需要登录并绑定付款方式,与 Basic 共用同一份账号额度;超出后按已购页数计费。也可以粘贴你自己的 Anthropic / OpenAI / Gemini 或任意 OpenAI 兼容端点的 API key,按你自己的成本继续转扫描页——自带 API key 的转换完全不计入额度。
转出来的 Word 能直接改吗,会不会一动就乱?
判断一份转换好不好,不看它刚打开时像不像,而看你改一下会怎样。我们重建的是原生 Word 对象:标题和正文是真正的 Word 样式,表格是真正的行和列,填写线、格线、四线三格是结构而不是一张图。所以删掉一句话,段落会重排;改表格里的一个数字,那一行不会塌;插入一行,后面的内容往下推,而不是整页散架。
PDF 转 Word 之后字体变了,怎么办?
.docx 里存的是字体的名字,不是字体本身,Word 会在打开它的那台机器上去找这个名字。仿宋、楷体随 Windows 和 Mac 版 Office 一起装;而它们的旧名 仿宋_GB2312、楷体_GB2312 两边都不带,文档里写旧名就可能在 Mac 上被换成别的字体。所以只要原文那套字体量得出来,我们写进 .docx 的就是它的现行规范名(宋体、黑体、仿宋、楷体、微软雅黑),也不会把字体嵌进文件里。要发给别人时,把中文正文设成对方一定有的字体最稳妥——因为正文是真正的 Word 样式,改一次样式就够了。
需要注册或安装软件吗?文件会留多久?
都不需要。整个过程在浏览器里完成:上传、转换、下载 .docx,不用装软件、不用留邮箱、成品没有水印。转换产物大约六小时后自动删除——如果你转的是合同、专利或者客户文件,这一点值得知道。